
こんにちは!カスタマーサクセスチームです。
日々、Linuxの組込みシステムやアプリケーション開発に取り組んでいるエンジニアの皆様、デバッグやパフォーマンス検証で「想定以上に時間がかかっている」と感じることはありませんか?
実際、開発現場のお客様とお話ししていると、「原因特定のためにカーネルやアプリを何度もビルドし直して半日が潰れた」「再現性の低い不具合やレスポンス遅延の調査で泥沼にはまっている」といったご相談を非常に多く受けます。
この記事では、Linuxのアプリケーション・デバイスドライバ開発で誰もが直面する「デバッグの壁」と、その背景にあるカーネルビルドの時間コスト問題を整理した上で、カーネルの再ビルドを行わずにアプリの動作とカーネル内部の非機能情報(CPU・メモリ・タスク遷移など)を紐付けてスマートに一元解析するアプローチをご紹介します。
CONTENTS
開発現場からよく聞く「Linuxデバッグ」4つの壁
お客様の現場で特に聞こえてくるお悩みは、大きく分けて以下の4点です。
1. カーネルビルドという「隠れた莫大な時間コスト」
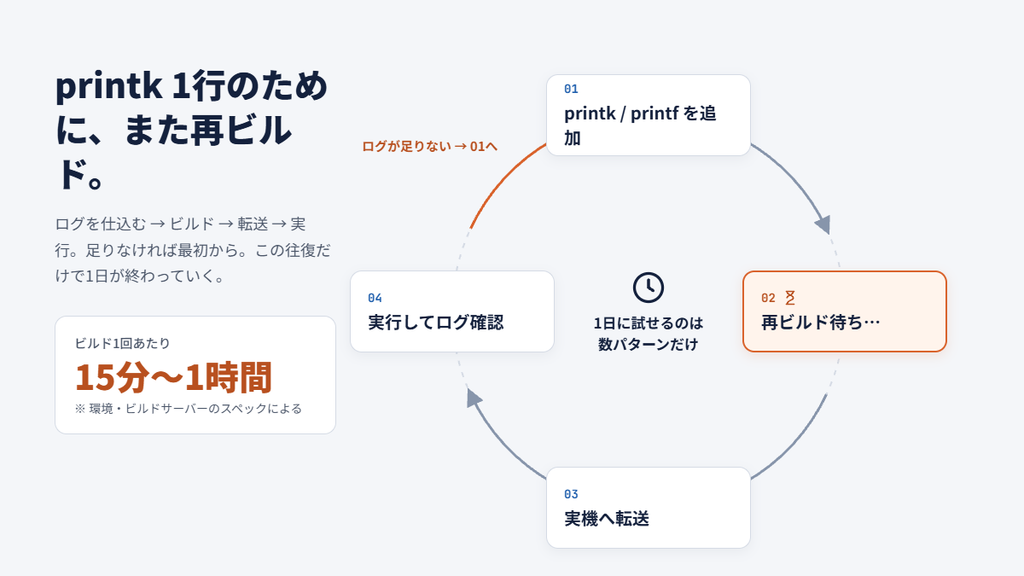
デバッグログ(printkなど)を1行仕込むだけでも、ソースコード変更後にカーネルの再ビルドが必要です。
ターゲット環境やビルドサーバーのスペックにもよりますが、フルビルドや差分ビルドに1回あたり15分〜1時間近くかかるケースも少なくありません。
- 試行錯誤の回数が制限される(1日の中で検証できるパターンが数回に限られる)
- ビルド待ちによってエンジニアの集中力が途切れる(作業の中断・再開に伴う生産性の低下)
- チーム全体のCI/CDパイプラインやテスト環境が停滞する
ビルド時間は「ただ待っている時間」のように見えて、プロジェクト全体の開発速度を著しく低下させる大きなコスト要因となっています。
2. printk / printf 埋め込みと再ビルドの無限ループ
ログを仕込んでビルドし、実機に転送して実行。意図したログが出なければ、さらにログを追加して再ビルド……。この繰り返しだけで1日が終わってしまうという経験は、多くのエンジニアが通る道です。
3. ログを入れた途端に消える「シュレディンガーのバグ」
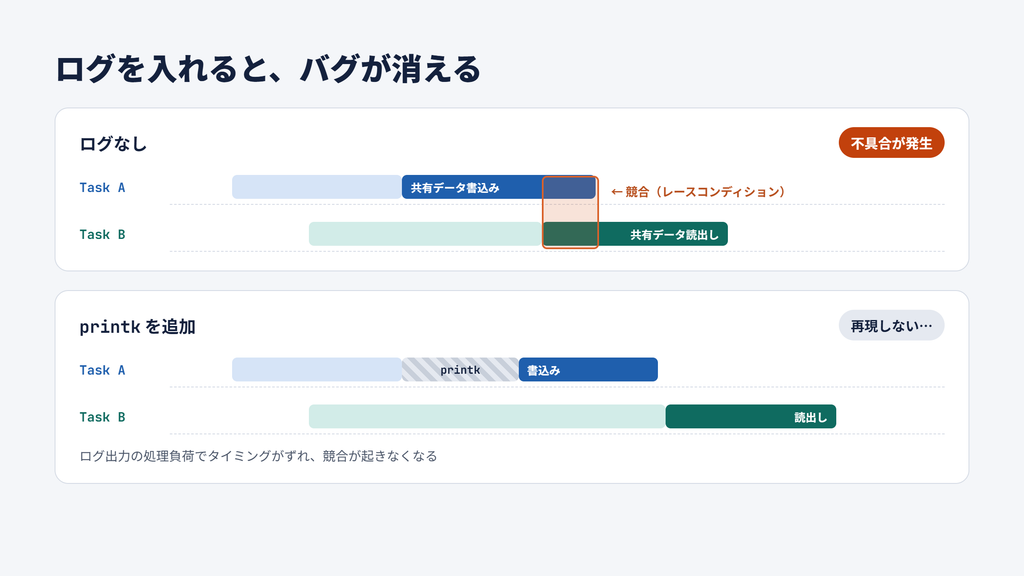
タイミング依存の不具合(レースコンディションや割り込みタイミングの問題)は、デバッグログ(printf /printk)を出力するための処理負荷そのものが影響し、「ログを入れるとバグが再現しなくなる」という現象を引き起こします。
4. アプリのログだけでは追えない「非機能要件の課題」
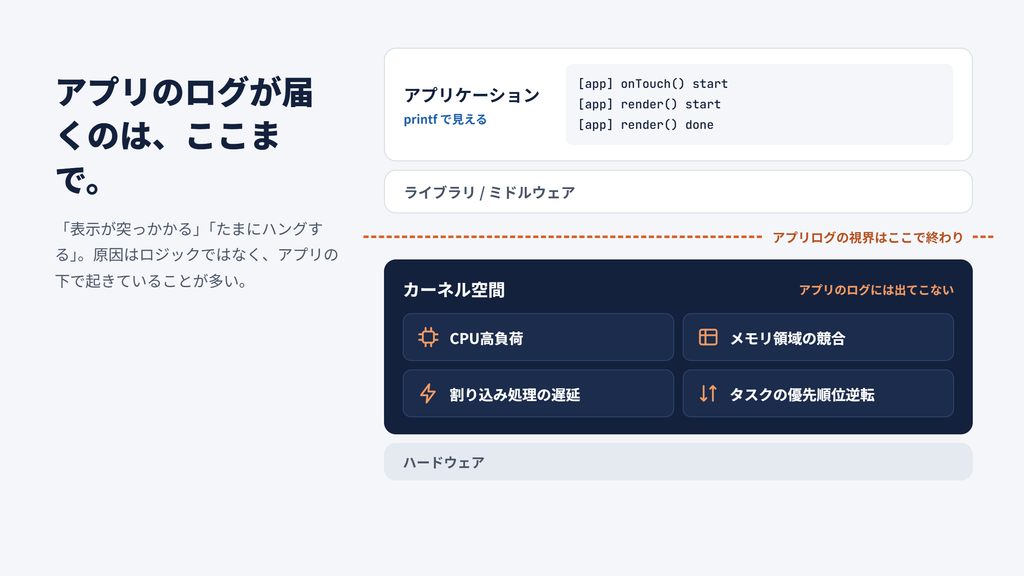
ロジック自体は正しいはずなのに、「なぜか特定の操作時に表示が突っかかる」「稀にタスクがハングアップする」といった非機能面の課題です。
アプリケーション層のログだけを追っていても、カーネル空間で起きているCPU高負荷、メモリ領域の競合、割り込み処理の遅延、タスクの優先順位逆転といった挙動は見えてきません。
現場が求める「理想のデバッグ・テスト環境」とは?
こうした課題を根本から解決するために、現場のエンジニアが真に必要としているのは以下のような環境です。
- カーネルやソースコードの「都度ビルド」が不要であること
検証環境のソースコードを変更せず、ビルド待ち時間ゼロですぐにトレース・解析を開始できること。 - アプリとカーネルの挙動を「同じ時間軸」で一元化できること
「アプリのこの関数が実行された瞬間、カーネル側でどのタスクが動作し、CPUやメモリはどう推移していたか」をクロス解析できる視認性。 - オーバーヘッドが極めて小さく、実機に近い状態で測定できること
計測処理自体がシステムに負荷を与えず、タイミング依存の不具合も正確に捉えられること。
カーネル再ビルドなしで非機能要件まで一元解析できるアプローチ
この「ビルド時間の排除」と「非機能要件の見える化」を両立させる手段として注目されているのが、動的テストツール(DT+など)の活用です。
1. アプリとカーネルの挙動を同一タイムラインで解析
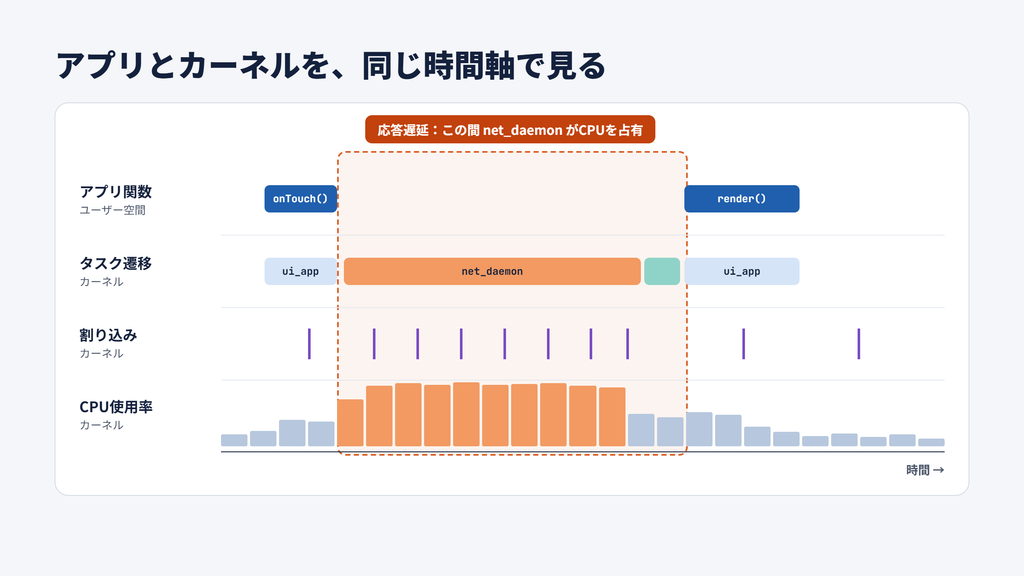
レスポンス遅延やタスク競合といった問題を調べるには、アプリケーションのログだけでなく、「そのときカーネル側で何が起きていたか」を把握することが不可欠です。
動的テストツールを活用することで、アプリケーションの処理とカーネル側のイベント(CPU使用率・タスク遷移・割り込みなど)を重ね合わせ、同じ時間軸で可視化できます。
これにより、「どの処理で応答が遅れ、その間にどのタスクが動作していたか」を一目で確認可能です。アプリとカーネルを個別に調べるのではなく、両者の相関関係から遅延や処理停滞の根本原因をピンポイントで絞り込むことができます。
2. カーネル/アプリの再ビルドなしでログを取得・管理
必要な計測環境を整えた後は、対応する範囲内でカーネルやアプリを再ビルドすることなく取得対象を設定し、ログを収集・管理できます。
ログを追加・変更するたびに「ソースコードの改変 ➔ 再ビルド ➔ 実機への転送」という不毛なサイクルを繰り返す手間を抑えられるため、1つの調査結果をもとに次の計測へとスムーズにステップを進められます。
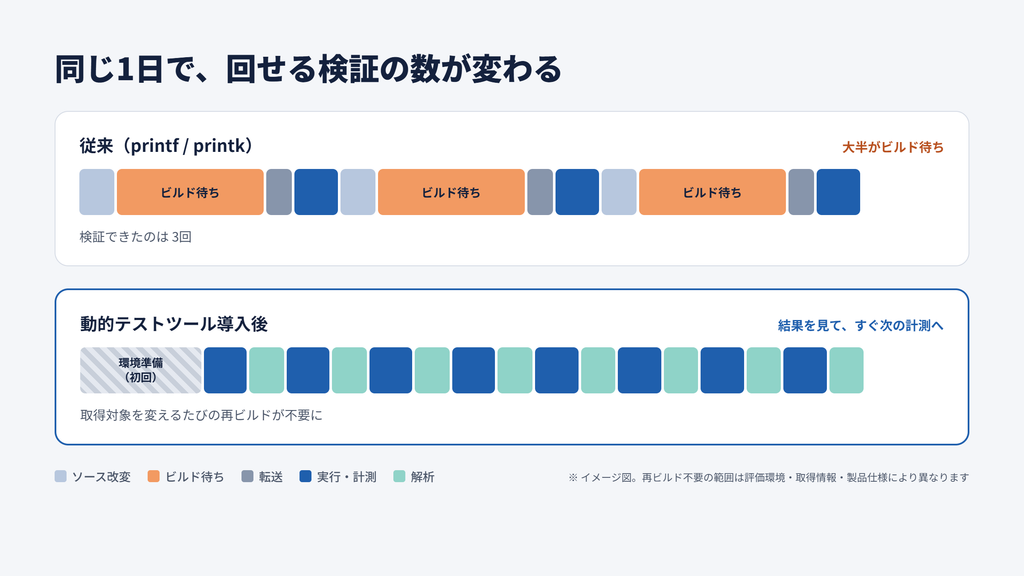
※「再ビルド不要」の適用範囲や初期設定の要否については、対象となる評価環境、取得したい情報の種類、およびご使用されるツールの製品仕様によって異なります。
従来のアプローチ vs 動的テストツール(ビフォーアフター)
| 評価項目 | 従来のデバッグ手法(printf / printk) | 動的テストツール導入後 |
|---|---|---|
| 事前準備 | ログ追加のためのソース改変・再ビルド必須 | 環境準備後は再ビルド不要(即検証へ移行) |
| 作業時間 | 1回の検証ごとに15分〜数時間のビルド待ち | ビルド待ちゼロ(検証サイクルを大幅高速化) |
| 解析範囲 | アプリ単体、またはピンポイントのカーネルログ | アプリ動作+カーネル内部挙動を同一タイムラインで解析 |
| 非機能解析 | 負荷やタスク競合などの原因特定が非常に困難 | CPU使用率・タスク遷移・割り込みを時間軸で視覚化 |
| 工数削減 | 原因特定までに数日〜数週間 | 再現実験1回で遅延や停滞の根本原因を特定 |
まとめ
Linux開発における最大のボトルネックは、コードそのものの複雑さだけでなく「デバッグとビルドにかかる時間コスト」、そして「アプリとカーネルの分断による非機能要件の解析難易度」にあります。
カーネルを都度再ビルドすることなく、アプリケーションとカーネル双方の動きを同じ時間軸でビジュアル化する動的テストツールを採り入れることで、泥沼の再現実験やビルド待ち時間から解放され、エンジニア本来の目的である「機能開発」や「システムの最適化」に集中できるようになります。
この記事が、日々Linux開発の現場で奮闘されている開発者の方や、これからLinux開発をスタートする方のヒントになれば幸いです。
今回は、アプリとカーネルの動きを一緒に捉え、不具合の原因を調べるアプローチについて紹介しました。同じように動きを記録して確認する方法は、処理時間やCPU負荷に問題がないかを検証する際にも役立ちます。こうした性能面の確認について、さらに知りたい方は、こちらの記事もご覧ください。
組込みLinuxの非機能要件とは?プロセス解析で見えない動作を可視化
機能が正しく動いていても、処理時間やCPU負荷に問題がないとは限りません。この記事では、組込みLinuxの「非機能要件」とは何か、DT+Traceでシステムの動きを記録して何を確認できるのかを解説。 ソフトウェア更新前後のデータを比べ、性能の変化を見つける検証の流れも紹介しています。